DeepSeek가 10월 17일 DeepSeek-V4.1-Flash-1017을 내놨습니다. 기존 V4.1-Flash를 손본 버전으로 웹과 앱, API에 곧바로 들어갔고 가중치도 MIT 라이선스로 공개됐어요. API에서 Flash 모델을 쓰던 사람은 설정을 바꾸지 않아도 이미 새 모델로 돌고 있습니다. 오픈소스 코딩 에이전트 OpenCode에서는 보안 침해 공지가 나왔습니다. 외부 AI 서비스를 연결해 둔 일부 사용자가 대상이에요.
오늘 하나만 본다면: DeepSeek-V4.1-Flash-1017
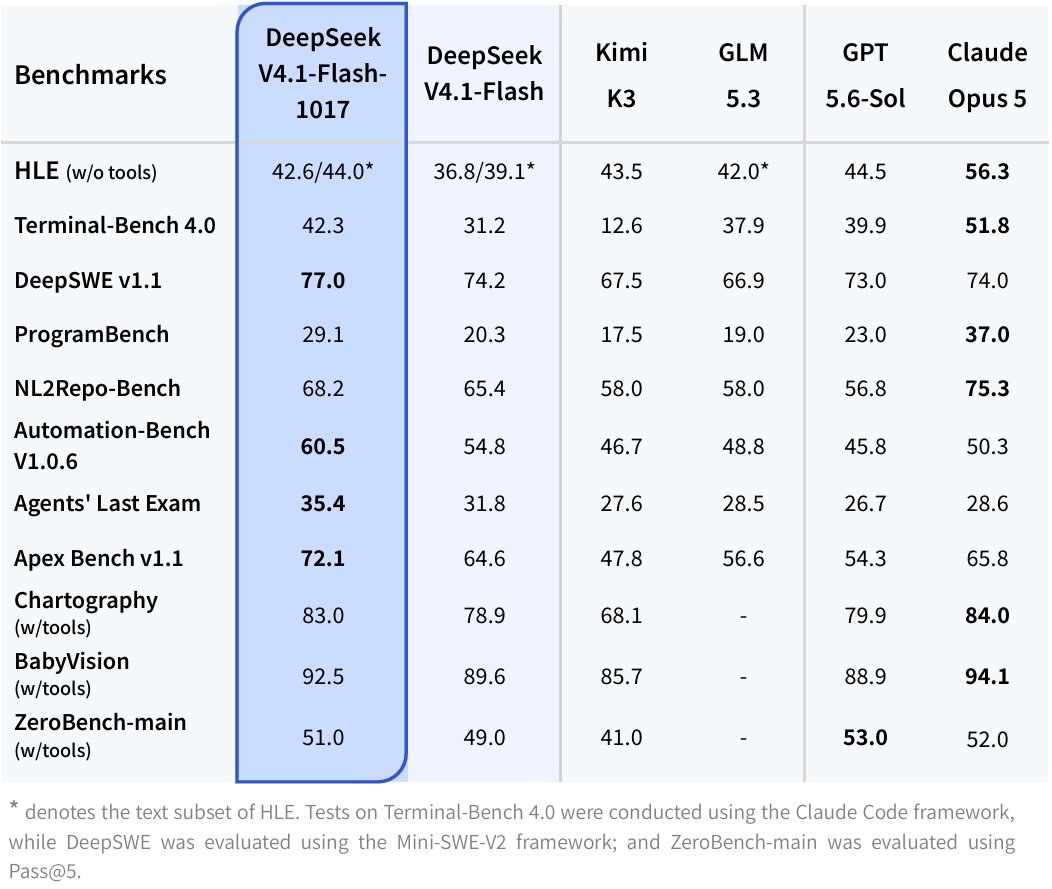
DeepSeek는 이번 버전을 작은 업데이트라고 소개합니다. 그런데 숫자는 꽤 움직였어요. Claude Code 하네스로 잰 Terminal-Bench 4.0은 31.2점에서 42.3점으로 올랐고 코딩 과제 벤치마크인 DeepSWE v1.1은 74.2점에서 77.0점이 됐습니다. 일을 끝내는 시간과 답 길이도 줄었다고 해요. 출력 토큰이 적으면 같은 일을 맡겨도 요금이 덜 나옵니다.
API에서 부르는 모델 이름은 deepseek-flash입니다. 예전 이름 deepseek-v4-flash나 deepseek-v4-flash-vision-exp로 보내도 요청은 들어갑니다. 그 이름의 옛 모델은 이미 은퇴해서 새 1017 모델이 대신 답하고 요금도 Flash 기준으로 매겨져요. 컨텍스트는 100만 토큰이고 한 번에 받을 수 있는 출력은 최대 38만 4천 토큰입니다. 이미지 입력도 받습니다.
요금은 시간대마다 다릅니다. 100만 토큰당 입력(캐시 미스) $0.3, 출력 $1.2가 기본이고 한가한 시간에는 그 절반인 $0.15와 $0.6입니다. 붐비는 시간은 평일 UTC 01~04시와 06~10시입니다. 한국시간으로는 평일 오전 10시~오후 1시와 오후 3시~7시예요. 주말과 중국 공휴일은 종일 할인 요금이 적용됩니다.
Search·Fetch API도 이번에 모두에게 열렸습니다. DeepSeek가 직접 만든 검색 엔진으로 웹을 찾고 페이지 내용을 가져오는 API인데 각각 1,000건에 $0.75입니다. DeepSeek Harness나 Claude Code, Codex에 DeepSeek API를 물려 쓰면 서버 쪽 도구가 이 API를 대신 부릅니다. 이 호출은 지금 무료고 10월 31일 16:00 UTC, 한국시간 11월 1일 새벽 1시부터 돈이 나가요.
코딩 도구에 붙여 쓴다면 DeepSeek Harness를 v0.2.1-rc.1 이상으로 올리라는 권고가 있습니다. Tencent CodeBuddy와 WorkBuddy에도 맞춰 손봤다고 하고요. 가중치는 Hugging Face와 ModelScope에서 받을 수 있습니다. 다만 Hugging Face 파일 기준으로 파라미터가 약 7,630억 개라서 개인 PC에서 돌릴 크기는 아닙니다.
확인해 둘 것: OpenCode 보안 침해
OpenCode는 오픈소스 AI 코딩 에이전트입니다. 10월 17일(미국 시간) OpenCode가 X에 전날 밤 보안 침해가 있었다고 알렸어요. 대규모 증류 공격과 관련된 일이고 OpenCode Console 사용자 1.4%가 영향을 받았다고 합니다. 증류 공격은 남의 모델에 질문을 대량으로 던져서 받은 답을 자기 모델 학습에 쓰는 수법을 가리킵니다.
피해 범위는 외부 공급자를 연결해 둔 사용자 일부입니다. OpenCode는 공지 당일 아침 이들에게 메일을 보냈습니다. 메일을 못 받았다면 영향이 없다고 해요. 사고 대응이 아직 끝나지 않아 자세한 내용은 공개하지 않았습니다. Anthropic·OpenAI·Google과 함께 수습하는 중이라고 합니다.
Hacker News에는 "사용자 자격 증명이 유출됐다"는 제목으로 올라왔습니다. 하지만 OpenCode 공지에는 무엇이 새어 나갔는지 나와 있지 않아요. OpenCode Console에 다른 AI 서비스를 연결해 썼다면 OpenCode에서 온 메일이 있는지부터 보세요.
써볼 만한 도구: llmspeed
로컬 LLM을 돌릴 그래픽카드나 Mac을 고르는 중이라면 llmspeed를 열어 볼 만합니다. 기기와 모델을 고르면 그 조합에서 예상되는 속도 그대로 답이 화면에 찍혀 나와요. 첫 글자가 뜨기까지 기다리는 시간도 반영됩니다. 두 구성을 나란히 놓고 경주를 붙일 수도 있습니다.
양자화 단계마다 모델이 메모리에 다 들어가는지, 일부를 시스템 메모리로 넘겨야 하는지, 아예 안 도는지도 알려 줍니다. 지금 다루는 건 GPU·Mac·CPU 30종과 모델 15개예요. RTX 4090에 Llama 3.1 8B(Q4_K_M)를 고르면 초당 86~129토큰, 첫 토큰까지 0.31초가 나옵니다. 숫자 옆에는 실측값인지, 비슷한 구성에서 끌어낸 값인지, 사양으로 계산한 값인지 표시가 붙어 있으니 같이 확인하세요. MIT 라이선스 오픈소스이고 Hacker News 첫 화면에도 올랐습니다.